
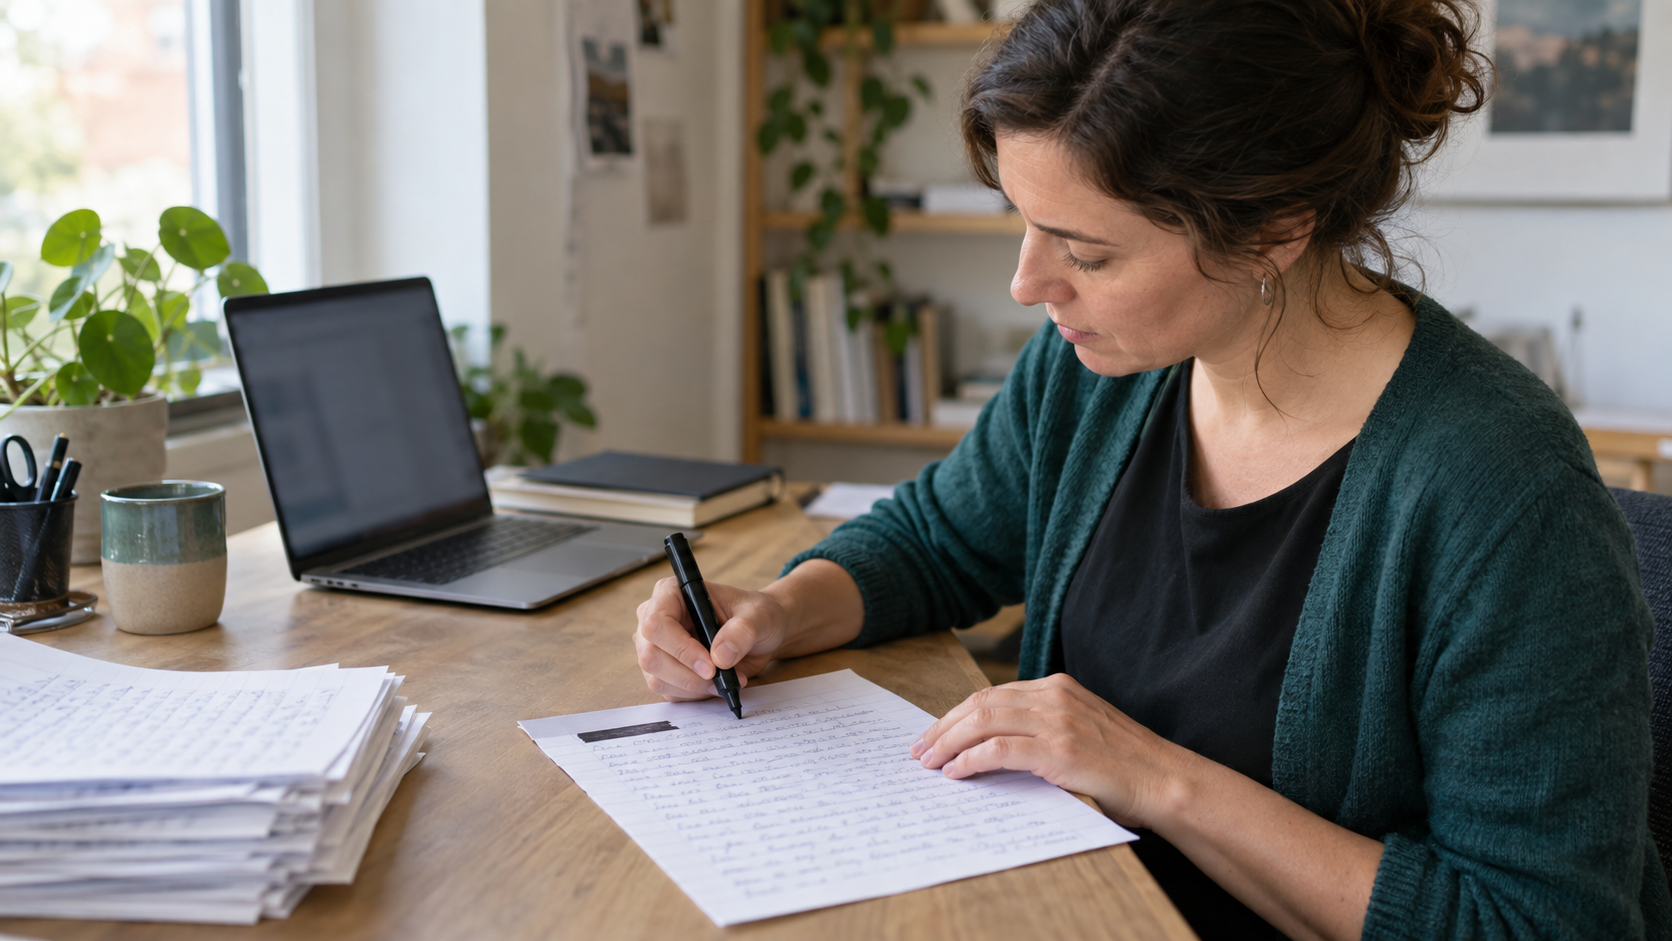
Titelbild wurde mit KI erstellt.
Es ist Montagabend und vor mir liegt ein Stapel Modelltests. Briefe, die meine Teilnehmenden geschrieben haben, jeder mit eigenen Fehlern, eigenen Formulierungen, eigenen kleinen Geschichten. Das Korrigieren gehört zu meinem Job. Nur bezahlt wird diese Zeit leider nicht. Als freiberufliche Dozentin bekomme ich nur die Zeit vergütet, in der ich tatsächlich unterrichte. Die Korrektur von Modelltests und Freitexten meiner Teilnehmenden fällt leider nicht darunter. Da kommt einem schnell der Gedanke: Ich arbeite doch längst mit KI, für Übungen und Spiele, für Textentwürfe, für Binnendifferenzierung. Warum also nicht auch Teilnehmertexte mit KI korrigieren? Ich könnte den Brief einfach abfotografieren, der KI geben und schreiben: „Bitte korrigieren.“ Ein paar Sekunden später hätte ich eine erste Fehlerübersicht, und ich müsste das Ganze nur noch überarbeiten.
Klingt verlockend. Doch darf ich das?
Der erste Reflex: Name schwärzen
Die Antwort scheint auf den ersten Blick einfach. Klar, ein Teilnehmertext enthält personenbezogene Daten, und die darf ich nicht ohne Weiteres einer KI geben. Aber dafür gibt es eine pragmatische Lösung: Ich schwärze einfach den Namen. Vielleicht noch das Geburtsdatum und die Adresse, falls die irgendwo auftauchen. Und schon ist der Text anonym, oder? Der Name ist ja das offensichtlich Persönliche. Ist der weg, ist die Person nicht mehr erkennbar, und der Datenschutz sollte kein Thema mehr sein. Ein schneller Handgriff, und der Weg zur KI-Korrektur ist frei.
Diese Annahme ist naheliegend. Sie ist auch weit verbreitet. Doch so einfach ist es leider nicht.
Warum das bei Freitexten nicht reicht
Bei einem reinen Ankreuztest kann eine Anonymisierung leichter möglich sein, weil der Inhalt meist wenig über die Person verrät. Aber auch hier kommt es auf das konkrete Dokument an. Name weg, und tatsächlich bleibt oft wenig, das zurückverfolgt werden könnte.
Bei einem Freitext sieht die Sache anders aus. Denn hier steckt die Person im Text selbst. Stell dir einen Brief aus einem Modelltest vor. Eine Teilnehmende schreibt, dass sie in der Küche eines Restaurants arbeitet, am Wochenende ihre Cousine besucht und gerade ihren Führerschein macht. Vielleicht ist das eine erfundene Prüfungsgeschichte. Vielleicht steckt aber ihr echtes Leben darin, und in der Lerngruppe ist längst bekannt, dass sie in der Gastronomie jobbt. Dazu kommen ihre typischen Fehler, ihre ganz eigene Art zu formulieren, vielleicht eine Wendung aus ihrer Muttersprache oder typische Fossilierungen, die immer wieder durchscheinen. Streiche ich den Namen, steht das alles trotzdem noch da.
Und jetzt kommt der Punkt: In einer Lerngruppe, die sich kennt, reicht der Inhalt oft aus, um zu wissen, wer da schreibt. Der Name spielt dabei kaum noch eine Rolle.
Anonym heißt nicht „Name geschwärzt“
Der entscheidende Begriff ist Anonymisierung, und der wird oft missverstanden. Anonym ist ein Text erst dann, wenn sich die Person mit realistischem Aufwand nicht mehr herausfinden lässt. So gründlich, dass auch jemand, der die Lerngruppe gut kennt, nicht mehr draufkommt, wer da geschrieben hat.
Und genau da liegt der Denkfehler beim Namen-Schwärzen. Ein geschwärzter Name fühlt sich sicher an, aber er macht den Text noch nicht anonym. Denn die Person steckt ja weiter im Inhalt: die Restaurantküche, die Cousine, der Führerschein, die typischen Fehler, die die Teilnehmerin beim Verfassen von Freitexten macht. Wer die Gruppe kennt, weiß auch ohne Namen, wer da schreibt.
Solange die Person auf diese Weise erkennbar bleibt, gilt der Text als personenbezogen. Und das hat eine handfeste Folge: Er unterliegt weiter dem Datenschutz, mit allem, was dazugehört. Erst wenn sich die Person auch mit realistischem Aufwand nicht mehr herausfinden lässt, fällt ein Text aus dem Datenschutzrecht heraus.
Wer also den Namen schwärzt und den Text dann in eine KI gibt, in dem Glauben, jetzt sei alles anonym, der irrt. Er verarbeitet weiterhin personenbezogene Daten, nur mit einem falschen Sicherheitsgefühl.
Selbst testen: die Tandem-Übung
Es gibt einen einfachen Weg, ein Gefühl für dieses Problem zu bekommen. Und der funktioniert direkt im Unterricht. Wenn du im Tandem arbeitest, probier mal Folgendes:
Nimm einen Freitext einer teilnehmenden Person, z. B. einen geschriebenen Brief. Entferne den Namen und alle offensichtlichen persönlichen Angaben wie Adresse oder Geburtsdatum. Gib den Text dann deiner Tandempartnerin, die denselben Kurs unterrichtet und die Lerngruppe genauso kennt wie du.
Und jetzt die Frage: Erkennt sie, wer den Text geschrieben hat? Anhand der Ausdrucksweise, an typischen Fehlern, an den persönlichen Details, an einer Geschichte, die im Kurs vielleicht schon mal erzählt wurde?
Der Grund, warum dieser Test funktioniert: Du selbst wärst ein schlechter Prüfer. Du weißt ja schon, von wem der Text stammt, und würdest die Person immer erkennen. Deine Tandempartnerin geht unvoreingenommen ran. Erkennt deine Tandempartnerin die Person, die den Brief geschrieben hat, ist die Sache klar: Der Text ist weiter zuordenbar, trotz geschwärztem Namen. Erkennt sie die Person nicht, heißt das aber noch nicht, dass der Text damit anonym wäre. Vielleicht käme jemand anderes drauf, oder andere Angaben führen doch zur Person. Der Test zeigt dir also zuverlässig, wann ein Text nicht anonym ist. Umgekehrt ist er kein Freibrief.
Löst eine lokale KI das Problem?
Vielleicht bist du ja ein gewitzter KI-Fuchs und denkst: Naja, dann nehme ich eben eine lokale KI. Eine, die auf meinem eigenen Rechner läuft und keine Daten in irgendeine Cloud schickt. Damit ist das Datenschutzproblem doch gelöst, richtig?
Der Gedanke ist naheliegend und gar nicht verkehrt. Eine lokale Lösung kann gegenüber einem öffentlichen KI-Dienst echte Vorteile haben, schon weil die Daten nicht an einen externen Anbieter gehen. Nur löst das nicht alles. Auch auf dem eigenen Rechner werden weiterhin personenbezogene Daten verarbeitet, und genau die Verarbeitung ist der Punkt, an dem das Datenschutzrecht ansetzt.
Für uns freiberufliche Dozent:innen kommt eine Besonderheit dazu. Ob wir über so eine Verarbeitung überhaupt allein entscheiden dürfen, hängt von unserem Auftrag ab und davon, was mit dem Träger vereinbart ist. Daraus ergibt sich eine Reihe von Fragen: Darf ich die Texte meiner Teilnehmenden überhaupt durch eine KI verarbeiten lassen? Ist das vom Auftrag des Trägers gedeckt, oder braucht es dafür eine ausdrückliche Erlaubnis? Wo werden die Texte gespeichert, und wer hat Zugriff darauf?
Für mich folgt daraus: Solange diese Fragen in meinem Unterrichtskontext ungeklärt sind, gebe ich auch einer lokalen KI keine echten Teilnehmertexte.
Und jetzt?
Was bleibt also? Die KI-gestützte Vorkorrektur wäre für uns freiberufliche Dozent:innen ein echter Gewinn. Sie könnte uns bei einer der zeitraubendsten und leider meist unbezahlten Aufgaben entlasten. Technisch ist vieles davon längst machbar.
Die entscheidende Frage lautet deshalb: Wie gehen wir mit den Daten unserer Teilnehmenden um? Und diese Frage lässt sich nicht mit einem schnellen Handgriff lösen, auch nicht mit dem Schwärzen eines Namens.
Das heißt nicht, dass KI beim Korrigieren tabu ist. Ich kann mir sogar vorstellen, dass sich in diesem Bereich in den kommenden Jahren noch so einiges drehen wird. Auch die Prüfungslandschaft wird zunehmend digitaler. So führt telc seit 2026 mit DIGItelc 2.0 eine neue Plattform für digitale Prüfungen ein. Eine KI-gestützte Korrektur folgt daraus zwar noch nicht. Die Entwicklung zeigt aber, dass digitale Prozesse selbst in diesem sensiblen Bereich an Bedeutung gewinnen. Die Frage, die wir uns stellen und klären müssen, ist: Was darf überhaupt in die KI, und unter welchen Bedingungen? Genau darum geht es in den nächsten Beiträgen dieser kleinen Reihe. Als Nächstes schaue ich mir an, ob und wie sich die KI-gestützte Vorkorrektur praktisch umsetzen ließe.
Mich interessiert, wie es bei dir aussieht: Wie handhabst du das Korrigieren mit KI in deinem Unterricht? Gibt es bei deinem Träger schon Regelungen dazu, oder ist das eine offene Frage? Schreib es gern in die Kommentare.
Schreibe einen Kommentar